GPT 生图 API:统一接口,按量计费
和 OpenAI 官方协议完全一致,改一个 Base URL 就能出图。这一页把型号、价格、参数、三种语言的示例、两种返回格式和常见报错全部写清楚,照抄能跑。
- Base URL
https://codexplus.shop/v1- 请求
POST /v1/images/generations- 鉴权
Authorization: Bearer <你的 Key>- 价格
- 所有生图模型统一一个价,5 厘起,按张计费
- 协议
- OpenAI Images API 兼容,官方 SDK 直接可用
一、三分钟跑通
先把密钥放进环境变量,然后用 curl 打一发。拿到 data[0] 里的图就算通了。
export CODEXPLUS_BASE="https://codexplus.shop/v1"
export CODEXPLUS_KEY="YOUR_API_KEY"

curl "$CODEXPLUS_BASE/images/generations" \
  -H "Authorization: Bearer $CODEXPLUS_KEY" \
  -H "Content-Type: application/json" \
  -d '{
        "model": "gpt-image-2",
        "prompt": "一只赛博朋克风格的猫,霓虹夜景,电影感",
        "n": 1,
        "size": "1024x1024"
      }'
返回是这样(字段位置和 OpenAI 官方一致):
{
  "created": 1763107200,
  "data": [
    { "b64_json": "iVBORw0KGgoAAAANSUhEUg..." }
  ]
}第一个坑就在这里:data[0] 里可能是 b64_json,也可能是 url。取决于型号和上游实现。第六节给出两种都能跑的写法——只处理一种,另一种情况下会存出 0 字节文件。
二、接口约定
| 项 | 值 | 说明 |
|---|---|---|
| 方法 | POST | 只接受 POST |
| 路径 | /v1/images/generations | 和 OpenAI 官方同路径 |
| Base URL | https://codexplus.shop/v1 | 必须带 /v1,少写会 404 |
| Content-Type | application/json | 用 SDK 时自动带 |
| 鉴权 | Authorization: Bearer <Key> | Key 在控制台「令牌」页创建 |
| 计费 | 按张,5 厘起 | 不按 token,n=4 就是 4 张的钱 |
| 同步/异步 | 同步 | 请求会等到图片生成完才返回 |
三、型号、价格与实测
在售型号分成两族,价格统一一个价,选哪个只影响出图风格,不影响单价。
| 型号 | 族 | 适合 |
|---|---|---|
gpt-image-2 | GPT 生图 | 日常出图首选,通用档 |
gpt-image-2.5 | GPT 生图 | 同系列版本号,效果取向与 2 略有差异 |
gpt-image-2.5-flare | GPT 生图 | 同系列变体 |
gpt-image-2.5-sunburst | GPT 生图 | 同系列变体 |
gpt-image-2.6 | GPT 生图 | 更新的版本 |
grok-imagine-image-lite | Grok 生图 | 该分组暂无可用渠道(实测返回 503),暂不售卖 |
grok-imagine-image-2.0 | Grok 生图 | 可用性以控制台模型页为准 |
型号列表跟着上游更新,实时可用性以控制台「模型」页为准,这页不写死。
计价口径:先把这个讲清楚
后台以美元计价,额度按 1 元 = 1 美元额度 兑换,所以下面所有美元价格就等于人民币价格,不用再乘汇率。
| 项 | 值 | 说明 |
|---|---|---|
| 模型单价 | $0.5 / 张 | 后台标价,所有 gpt-image 型号同价 |
| 分组倍率 | 0.01x | image 0.005 分组 |
| 实际扣费 | $0.005 / 张=0.005 元=5 厘 | 0.5 × 0.01,即 5 厘 |
| 额度扣减 | 2,500 额度/张 | 1 元 = 1 美元 = 500,000 额度 |
| 计费方式 | 按张,不按 token | n=4 收 4 张的钱 |
| 额外费用 | 无 | 无月费、无开通费、无最低消费、无图片存储费 |
| 失败是否扣费 | 不扣 | 上游无可用渠道返回的 503,实测未产生扣费记录 |
按型号的真实单张价格
下面每一行的「额度扣减」都来自真实调用后的计费日志,不是照标价推算的。
| 型号 | 标价 | 倍率 | 实扣(美元) | 实扣(人民币) | 额度扣减 |
|---|---|---|---|---|---|
gpt-image-2 | $0.5/张 | 0.01x | $0.005 | 0.005 元 | 2,500 |
gpt-image-2.5 | $0.5/张 | 0.01x | $0.005 | 0.005 元 | 2,500 |
gpt-image-2.5-flare | $0.5/张 | 0.01x | $0.005 | 0.005 元 | 2,500 |
gpt-image-2.5-sunburst | $0.5/张 | 0.01x | $0.005 | 0.005 元 | 2,500 |
gpt-image-2.6 | $0.5/张 | 0.01x | $0.005 | 0.005 元 | 2,500 |
gpt-image-2.6-sunburst | $0.5/张 | 0.01x | $0.005 | 0.005 元 | 2,500 |
为什么「统一一个价」:这六个型号在后台标价都是 $0.5/张,走同一个 0.01x 分组,所以选哪个型号都是 5 厘一张。区别只在出图风格。
不在这个分组的型号:grok-imagine-image-lite 在后台有标价,但该分组下暂无可用渠道,实测返回 503,所以不列入上表。
真实调用实测
2026-11-14 实测,同一句 prompt、同一尺寸(1024×1024)、同一分组,只换型号。下表是每一次调用的真实结果。
| 型号 | 耗时 | 返回格式 | 图片体积 | 扣费 |
|---|---|---|---|---|
gpt-image-2 | 32.0 s | b64_json | 2,263,325 B | 2,500 额度 |
gpt-image-2.5 | 30.8 s | b64_json | 2,291,537 B | 2,500 额度 |
gpt-image-2.5-flare | 30.5 s | b64_json | 2,481,027 B | 2,500 额度 |
gpt-image-2.5-sunburst | 29.0 s | b64_json | 2,344,380 B | 2,500 额度 |
gpt-image-2.6 | 30.2 s | b64_json | 2,769,839 B | 2,500 额度 |
gpt-image-2.6-sunburst | 30.3 s | b64_json | 2,622,100 B | 2,500 额度 |
- 耗时:29–32 秒,六次全部落在 30 秒上下。客户端超时请设 120 秒以上。
- 返回格式:这批全部是
b64_json(响应体 3.0–3.7 MB)。但不保证永远是——第六节的两种分支还是要都写。 - 图片体积:1024×1024 的 PNG,2.2–2.8 MB,无水印、无压缩。
样张:同 prompt,只换型号
下面三张是上面实测里真实返回的图片(原图转 WebP,画质 82%,尺寸未改)。是为了让人能直接比出差异,不是精修的宣传图。
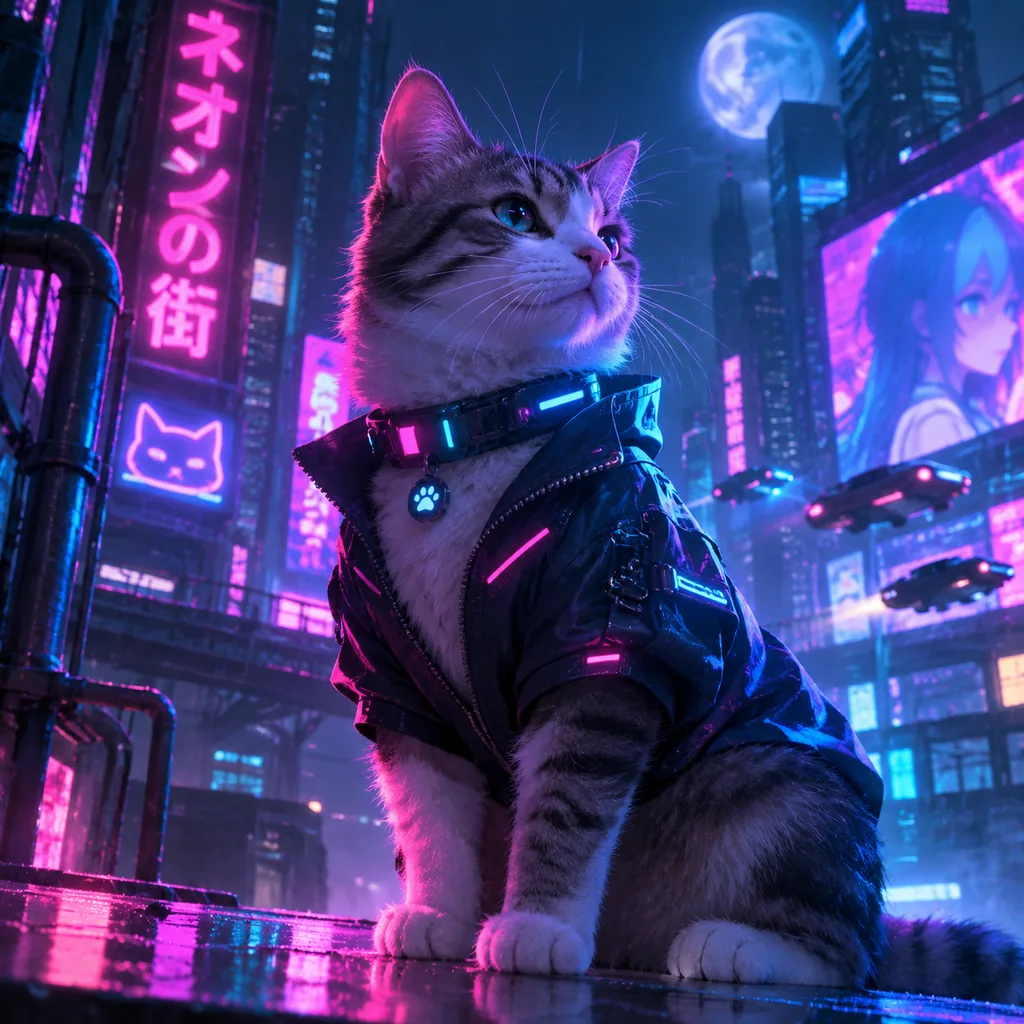
gpt-image-2 · 32.0 s · $0.005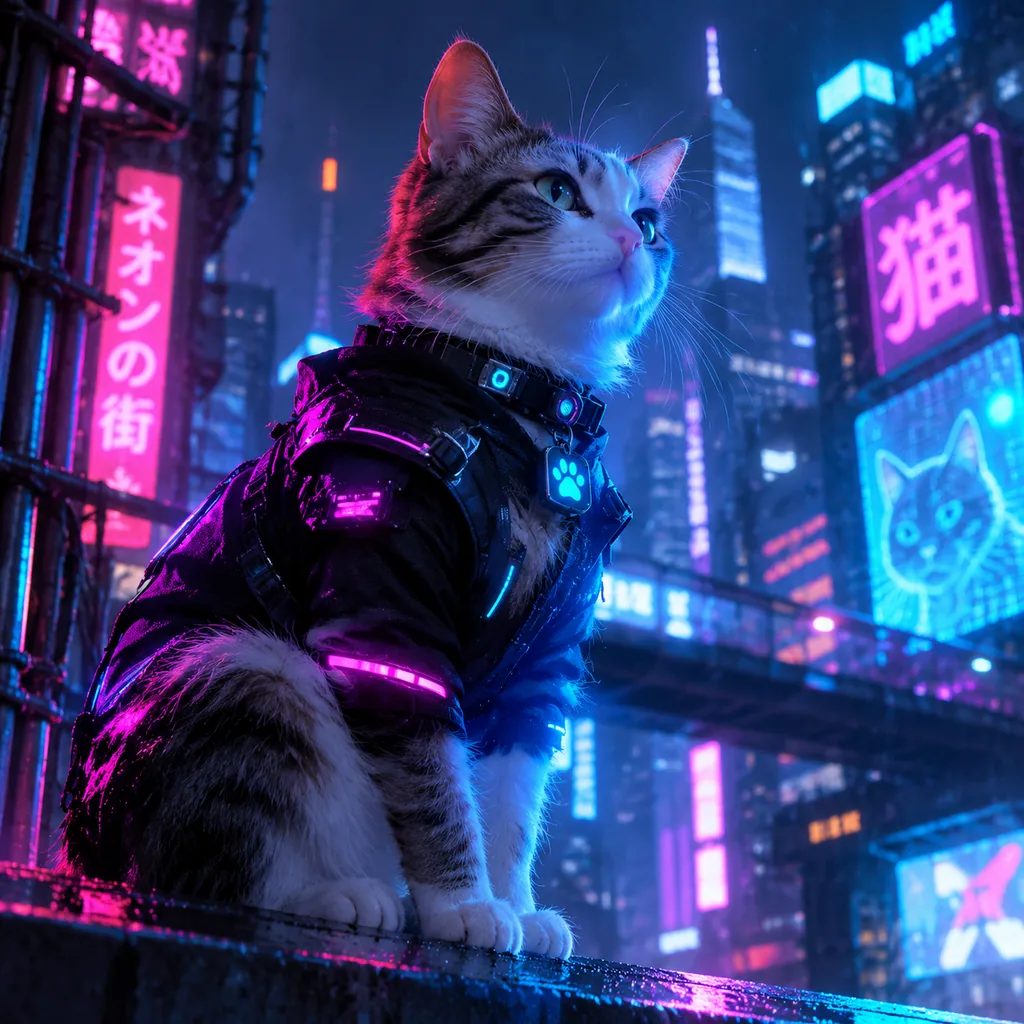
gpt-image-2.5 · 30.8 s · $0.005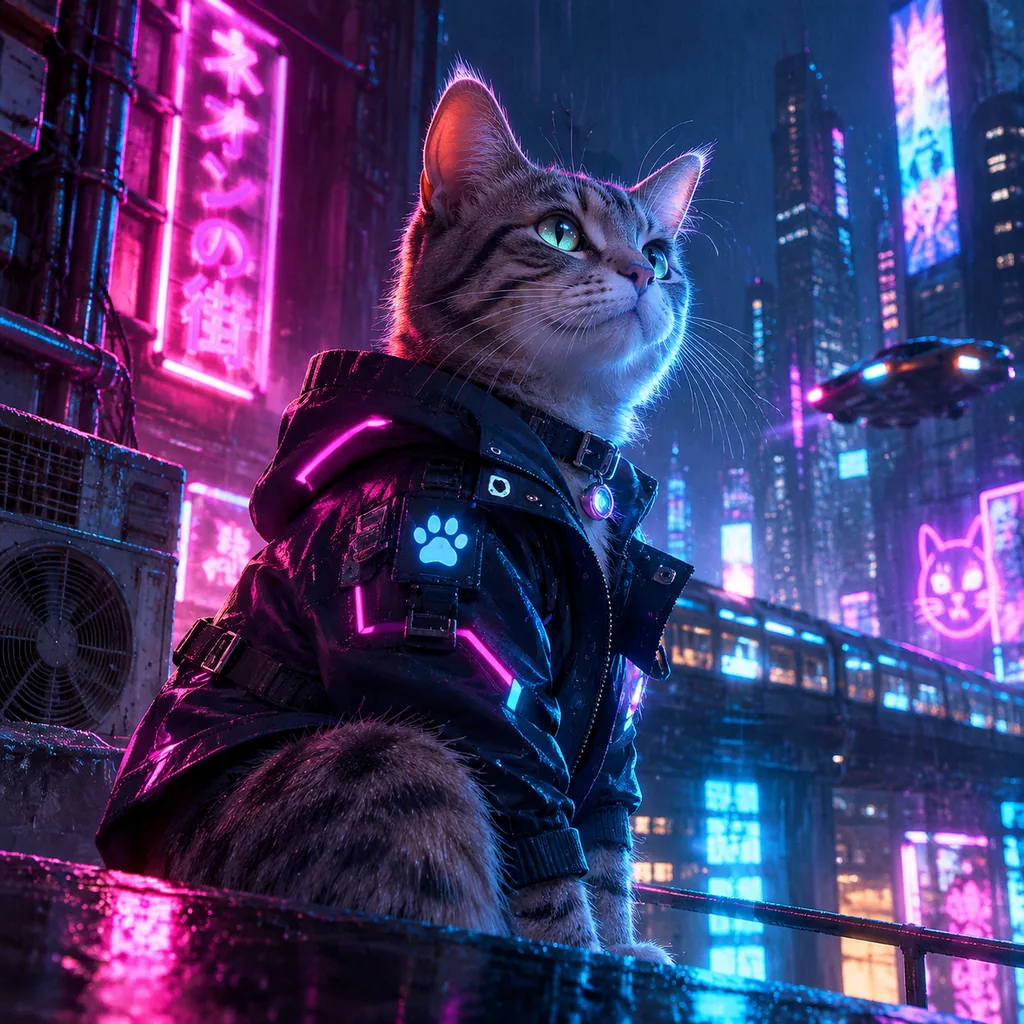
gpt-image-2.6 · 30.2 s · $0.005分辨率支持
| 尺寸 | 方向 | 状态 |
|---|---|---|
1024x1024 | 方 | 实测通过,六次调用全部返回 1024×1024 |
1536x1024 | 横 | 官方通用档,本页未实测 |
1024x1536 | 竖 | 官方通用档,本页未实测 |
本页只写实测过的结论。其它尺寸是否可用、是否加价,以控制台模型页为准;不支持的尺寸会直接返回 400,不会自动缩放到最近的支持值。
四、参数说明
| 参数 | 必填 | 类型 | 说明 |
|---|---|---|---|
model | 是 | string | 生图型号,见上一节 |
prompt | 是 | string | 画面描述。中文可用;要画面里出现准确的文字,把那段字用引号括起来 |
n | 否 | int | 一次出几张,默认 1。按张计费,n=4 收 4 张的钱 |
size | 否 | string | 通用档:1024x1024 方、1536x1024 横、1024x1536 竖。其它尺寸看型号是否支持,不支持会 400 |
quality | 否 | string | 部分型号支持,取值以控制台模型说明为准;不支持的型号会忽略这个字段 |
response_format | 否 | string | b64_json 或 url。不支持时被忽略,所以代码要按返回内容自适应 |
尺寸不是越大越好。超出型号支持范围直接 400,不会自动缩。先用 1024x1024 跑通,再逐步试更大的。
五、三种语言写法
Python(官方 SDK)
import base64, pathlib, urllib.request
from openai import OpenAI

client = OpenAI(
    base_url="https://codexplus.shop/v1",
    api_key="YOUR_API_KEY",
)

resp = client.images.generate(
    model="gpt-image-2",
    prompt="一只赛博朋克风格的猫,霓虹夜景,电影感",
    size="1024x1024",
    n=1,
)

item = resp.data[0]
b64 = getattr(item, "b64_json", None)
url = getattr(item, "url", None)

if b64:
    pathlib.Path("out.png").write_bytes(base64.b64decode(b64))
elif url:
    urllib.request.urlretrieve(url, "out.png")
else:
    raise RuntimeError("返回里既没有 b64_json 也没有 url")

print("done -> out.png")
Node.js
import fs from "node:fs";

const res = await fetch("https://codexplus.shop/v1/images/generations", {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    Authorization: `Bearer ${process.env.CODEXPLUS_KEY}`,
  },
  body: JSON.stringify({
    model: "gpt-image-2",
    prompt: "一只赛博朋克风格的猫,霓虹夜景,电影感",
    n: 1,
    size: "1024x1024",
  }),
});

if (!res.ok) throw new Error(`${res.status} ${await res.text()}`);

const { data } = await res.json();
const item = data[0];

if (item.b64_json) {
  fs.writeFileSync("out.png", Buffer.from(item.b64_json, "base64"));
} else {
  const img = await fetch(item.url);
  fs.writeFileSync("out.png", Buffer.from(await img.arrayBuffer()));
}
纯 curl
curl -sS "$CODEXPLUS_BASE/images/generations" \
  -H "Authorization: Bearer $CODEXPLUS_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-image-2","prompt":"霓虹夜景里的猫","size":"1024x1024"}' \
  -o out.json

# 返回里是 b64_json:解码成文件
python3 -c "import json,base64;d=json.load(open('out.json'))['data'][0];open('out.png','wb').write(base64.b64decode(d['b64_json']))"
六、返回格式怎么处理
这是接中转最容易翻车的地方,单独说清楚。
| 返回字段 | 是什么 | 怎么处理 |
|---|---|---|
data[0].b64_json | base64 编码的图片字节 | base64.b64decode() 后写文件 |
data[0].url | 一个可下载的图片链接 | 再发一次 GET 下载下来 |
为什么会出现两种:同一个接口在不同型号、不同上游实现下回传方式不同。response_format 传了也未必被遵守。
正确姿势:两个字段都判,先看 b64_json,没有再看 url,两个都没有就当错误抛出来——不要静默写一个空文件。
七、报错对照表
| 现象 | 原因 | 怎么解决 |
|---|---|---|
401 Unauthorized | Key 错、没带 Bearer、Key 被禁用或额度用完 | 先用 GET /v1/models 验证 Key 通不通 |
404 not found | Base URL 少了 /v1,或者路径写成 /images/generate | Base 用 https://codexplus.shop/v1,路径用 /images/generations |
400 invalid size | 该型号不支持这个分辨率 | 先用 1024x1024 打底,再换尺寸 |
400 model not found | 型号名写错,或该型号已下架 | 到控制台模型页复制准确型号名 |
返回 200 但 data 为空 | 内容策略拦截,或 prompt 触发了限制 | 换描述方式,去掉真实人名、品牌名、敏感场景 |
| 存出来的图是 0 字节 | 代码只处理了 b64_json,实际返回的是 url | 按第六节写两个分支 |
| 请求很久没返回 | 生图是同步接口,复杂 prompt 耗时长 | 客户端超时设到 120 秒以上,不要用 10 秒默认值 |
八、批量与并发
- 一次多张:
n参数,同一个请求返回多张,按张计费。 - 几十张以上:拆成多个请求并发跑,比单个
n=50稳。并发数自己压住,别把上游打满。 - 失败重试:429 和 5xx 可以退避重试;400 别重试,那是参数问题,重试也不会变。
- 超时:同步接口,单张复杂图可能要几十秒,客户端超时建议 ≥120 秒。
九、为什么要走中转
| 对比项 | 直连官方 | 走 Codexplus |
|---|---|---|
| 接入方式 | 官方 Key | 同一个协议,只换 Base URL |
| 付款 | 需要外币卡 | 人民币,按量扣 |
| 计价 | 按模型分档 | 所有生图模型统一一个价,5 厘起 |
| 网络 | 部分网络环境不稳 | 境内直连,不需额外代理 |
| 文本模型 | 另买 | 同一个 Key 也能调 GPT / Claude,见 GPT 中转 |
十、常见问题
GPT 生图用哪个接口?
和 OpenAI 官方一致:POST /v1/images/generations。Base URL 换成 https://codexplus.shop/v1 就行,官方 SDK 不用改一行代码。
生图多少钱一张?
每张 0.005 元(5 厘)。后台标价 $0.5/张,走 0.01x 倍率的 image 0.005 分组,实扣 $0.005;额度按 1 元 = 1 美元额度 兑换,所以折合人民币也是 0.005 元。
扣减 2,500 额度/张,按张计费不按 token。无月费、无开通费、无最低消费。失败不扣费。实时价格见定价页。
支持哪些生图模型?
gpt-image-2、gpt-image-2.5、gpt-image-2.5-flare、gpt-image-2.5-sunburst、gpt-image-2.6,以及 grok-imagine-image-lite、grok-imagine-image-2.0。完整列表以控制台模型页为准。
返回的是 b64_json 还是图片链接?
两种都可能出现,取决于型号与上游实现。先看 data[0].b64_json 有没有值:有就 base64 解码写文件,没有就下载 data[0].url。只判断其中一种,另一种情况下会存出 0 字节文件。
可以用 OpenAI 官方 SDK 吗?
可以。openai 库的 client.images.generate 直接能用,只需把 base_url 指向 https://codexplus.shop/v1。
Base URL 要不要带 /v1?
要。Base URL 写 https://codexplus.shop/v1,请求路径是 /images/generations,合起来才是 /v1/images/generations。少写 /v1 会 404。
4096x4096 这种大尺寸支持吗?
以型号为准。1024x1024、1536x1024、1024x1536 是通用档;其它尺寸要看具体型号,不支持时接口返回 400,不会自动缩放。
能批量出图吗?
同一个请求里用 n 一次出多张,n=4 就返回 4 张、按 4 张计费。要出几十张建议拆成多个请求并发,并自己控制并发数。